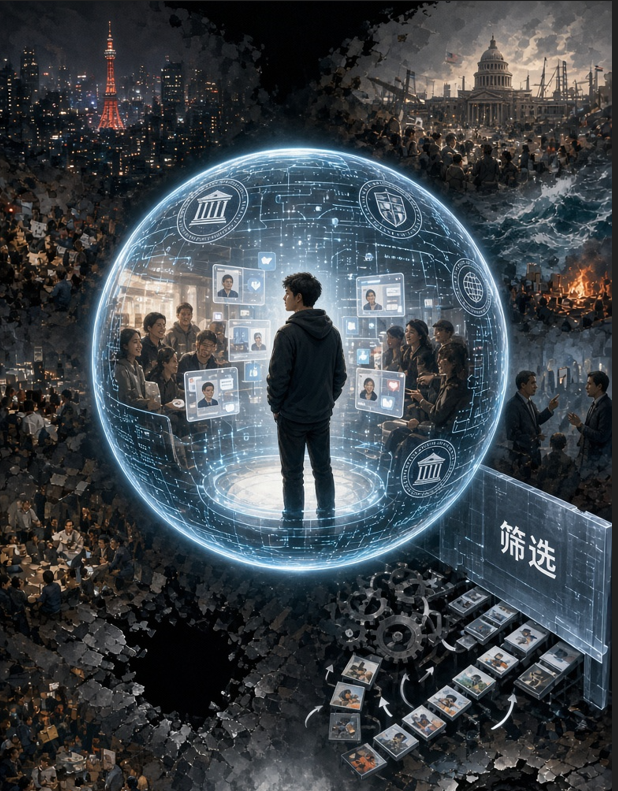
我们长期生活在被筛选的信息环境中,却不知道自己究竟没有看到什么。
作者:毕研韬 发表时间:2026年9月16日
我们越来越依赖社交媒体获得信息。新闻、国际事件、公共人物的言论,甚至一个国家和社会究竟是什么样子,很多时候都不是通过系统阅读报纸、观看电视或阅读研究报告获得,而是在刷视频、看热搜、读公众号和朋友圈的过程中逐渐形成印象。
这似乎意味着,我们比过去获得了更多信息。
但还有一个容易被忽略的问题:我们获得的信息越多,就一定越接近事实吗?未必。
真正值得警惕的,也许不是我们看到了多少错误信息,而是我们可能长期不知道自己没有看到什么。
讨论社交媒体的信息风险,人们首先想到的通常是假新闻、谣言、虚假信息和深度伪造。这些问题当然重要,但还有一种风险更加隐蔽:信息本身可能是真的,但我们看到的信息并不完整。
设想一个社会中存在关于某个议题的十种主要观点,而一个用户长期只能接触其中三四种。这个用户看到的每一条信息都可能是真实的,也可能都有来源、有证据,甚至没有任何一条是所谓的“假新闻”。
问题仍然存在。
因为由部分真实信息构成的整体图景,可能与真实社会的完整结构存在巨大差异。这可以称为信息分布失真。
例如,当我们观察台湾、美国、日本或其他社会时,真正重要的并不仅仅是“某个人说了什么”,还包括:这个人的观点在当地社会中处于什么位置?赞成和反对的声音各有多大?不同年龄、阶层、地区和政治群体如何看待同一个问题?
如果一个人长期接触到的只是某一类型的声音,他看到的可能不是真实的台湾、美国、日本,因为那只是真实的一部分。
问题由此发生变化:我们面对的未必是假世界,而可能是一个经过筛选的真实世界。
传统媒体时代,人们讨论新闻选择。记者、编辑和媒体机构决定什么进入报纸、电视和广播。
社交媒体改变了这种传播结构。
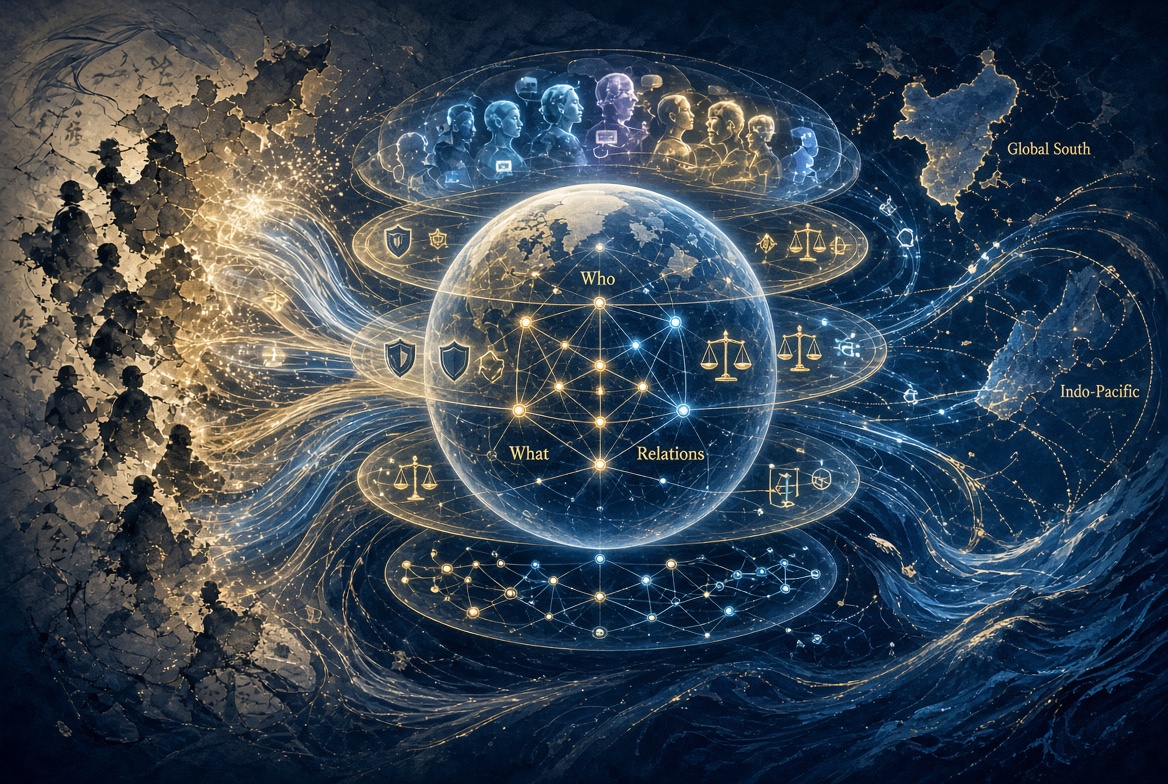
今天的信息传播大致经过这样一条链条:
现实世界→信息生产→制度性筛选→平台处理→算法排序→用户接触 →认知形成。
因此,“世界上发生了什么”和“一个用户看到了什么”,已经是两个不同的问题。
更重要的是,今天的“看见”并不是简单的主动选择。
算法推荐不是一个完全中性的“信息搬运工”,平台的信息发布审核、用户模型和用户标签管理等制度,都要求在首页首屏、热搜、精选、榜单等重点环节都要呈现符合主流价值导向的信息。
与此同时,平台本身也有商业逻辑。什么内容能够获得更多点击、停留、转发和互动,什么内容更容易得到推荐,本身就是一种重要的信息筛选机制。
因此,一个普通用户所面对的,并不是互联网中全部存在的信息,而是经过多重环节处理之后的可见信息。
这就是“信息可供性”问题。
所谓信息可供性,简单说,就是某种信息对于一个具体用户而言,究竟有多大可能被发现、获得、理解和持续接触。
信息存在,不等于信息可得。
信息可得,也不等于信息可见。
信息可见,更不等于信息会持续进入一个人的认知空间。
因此,与其简单讨论“信息茧房”,不如进一步追问:一个人的信息环境究竟是怎样形成的?
算法是一层筛选。
它根据用户过去的点击、阅读、停留和互动行为,对未来的信息进行排序。用户越喜欢某一类内容,就越容易继续遇到类似内容。
这是一种典型的平台化过滤。
但对一些具有高度政治敏感性的公共议题而言,还存在另一层结构性因素:制度性信息治理。
这里需要区分一个重要问题。
制度性治理本身有其政策目标,例如打击违法信息、网络诈骗、深度伪造和恶意操纵等。深度合成管理规定也要求平台建立内容审核和辟谣机制。
因此,问题并不是“存在治理,所以所有信息都是假的”。
真正需要研究的是:当制度性筛选与商业性、算法性筛选叠加以后,一个用户的信息样本空间会发生什么变化?
这才是传播学真正值得讨论的问题。
这里出现了一个非常重要的认识论问题。
假如我知道自己没有看到某种观点,我仍然可以保持警惕。
但如果我根本不知道这种观点存在,我甚至不会产生“我是否遗漏了信息”的问题。
这意味着,信息环境不仅能够影响一个人“相信什么”,还能够影响一个人知道什么可以被怀疑。
这是一种更深层次的认知影响。
我们通常把认知偏差理解为:看到了信息→相信了错误的信息。
但另一种情况可能是:根本没有接触某类信息→因而不知道自己缺少信息→把现有信息误认为完整信息。
后者更加隐蔽。
它甚至不表现为一个明显的错误判断。
一个人可能从未听说过某种观点,因此不会反驳它,也不会相信它。他只是完全意识不到这个观点存在。
于是,一个人的认知边界开始与信息边界重合。
他以为世界就是自己能够看到的世界。
这就是“我们不知道自己不知道什么”的含义。
传统的“信息茧房”理论,主要关注用户如何在选择和算法推荐的共同作用下越来越多地接触相似观点。
但今天的问题可能比信息茧房更复杂。
因为我们不仅需要研究:用户看到了什么?
还需要研究:用户为什么能够看到这些,而看不到另外一些?
再进一步:哪些信息从一开始就没有进入这个用户的可见信息空间?
这样一来,传播研究的分析对象就需要从内容,进一步向信息环境扩展。
可以把它简单表示为:信息生产→制度性筛选→平台性筛选→算法性排序→用户可见性→认知形成
过去我们容易把传播理解为“把信息送达受众”。
今天更值得研究的是:谁决定什么信息可以被谁看见?
这实际上改变了传播学关于“受众”的一个基本假设。
受众并不是面对一个完整的信息市场,然后自由选择自己喜欢的信息。很多时候,受众面对的是一个已经经过预处理的信息环境。
因此,传播权力也正在发生变化。
过去,传播权力更多表现为“谁能够发声”。
今天,它越来越表现为:谁能够让某种信息被看见,谁能够让某种信息持续被看见,以及谁能够决定什么信息很难被看见。
这个问题不能简单理解为某一个国家、某一种制度特有的问题。
美国、欧洲和其他国家同样存在平台算法、商业利益、用户画像、政治极化、媒体偏见和信息碎片化等问题。任何信息系统,只要存在平台、算法和内容选择,就不可能让每一个用户面对一个完整的现实。
区别更多在于:不同社会对于政治内容、平台责任、新闻来源和信息治理采取了不同制度安排,由此产生不同的信息可供性结构。
所以,真正值得讨论的不是:谁的信息环境绝对真实?
恐怕没有任何社会能够提出这样的保证。
更重要的问题是:一个社会有没有足够的机制,让人意识到自己的信息环境存在边界?
以及:一个人能不能相对低成本地接触到不同来源、不同立场和不同解释框架的信息?
这决定了一个社会的公众是否具有一种重要的能力——发现信息缺口的能力。,以及这个社会的信息韧性。
人工智能的发展可能使这个问题进一步加剧。
过去的信息筛选主要依赖搜索、推荐和人工编辑。
未来,人们可能越来越多地通过人工智能获取知识。AI会替用户总结、排序、解释和回答问题。
这无疑会大幅降低获取知识的成本,但也意味着另一个风险:当一个系统替我们完成信息筛选时,我们甚至可能不知道它替我们筛掉了什么?
过去我们至少可以看到搜索结果。
未来,我们可能直接得到一个答案。
这意味着信息可供性问题可能从“我看到了什么”进一步发展为:“我为什么会得到这个答案?”
因此,未来的信息素养不能必须包括一种更重要的能力:意识到自己的信息环境并不等于现实本身。
这就是所谓的“认知脱嵌”:暂时跳出自己习惯的信息环境,主动寻找被忽略的来源、不同的观点和相互竞争的解释框架,然后重新审视自己原来的判断。
它不是要求接受所有观点,更不是要求相信所有观点。
恰恰相反,它要求一个人在形成判断之前,先问自己一个非常简单的问题:我是不是只看到了这个问题的一部分?
这也许是社交媒体时代最重要却最容易被忽视的信息能力。
因为一个人最难发现的,不是真相之外的谎言,而是自己视野之外的真实。
我们真正需要警惕的,不只是被错误信息欺骗,而是在一个经过筛选的信息世界里,越来越确信自己已经看见了整个世界。
毕研韬系传播学教授,主要研究国际传播、国际冲突与和平。本文仅代表作者个人观点,不代表所在机构之立场。